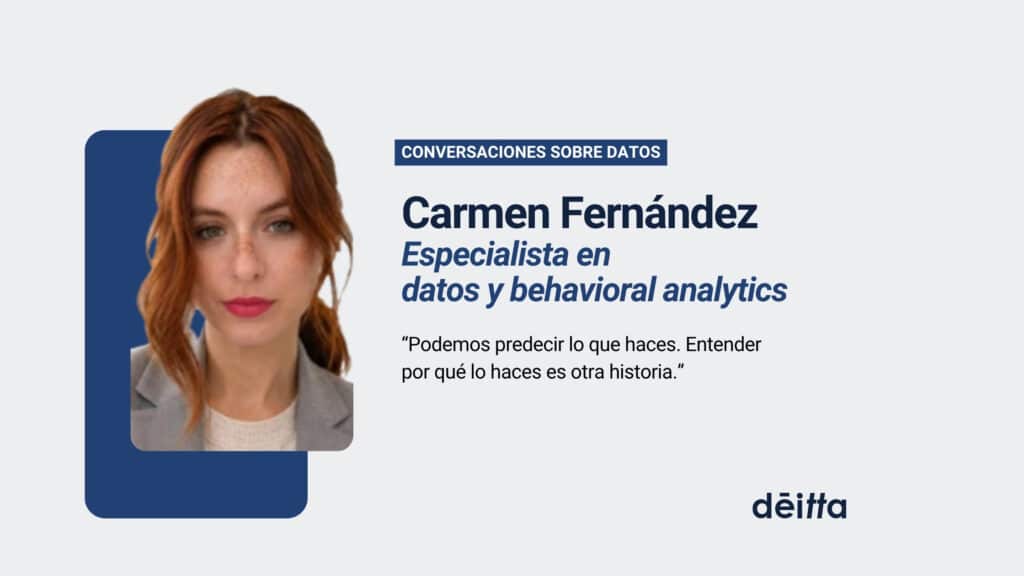
“Podemos predecir lo que haces. Entender por qué lo haces es otra historia.”
Carmen Fernández Sobrino, especialista en datos y behavioral analytics, habla de los límites del dato: por qué el contexto y la motivación importan tanto como el comportamiento observado, y por qué, a veces, la mejor fuente de información es preguntar.
La invitada
Carmen Fernández Sobrino
Data Analyst · End-to-End Analytics · Profesional independiente
Carmen Fernández Sobrino es especialista en datos y analítica de negocio, con formación en Empresa, Derecho e Inteligencia Artificial. Su perfil combina Business Analytics, Data Science e ingeniería de datos para transformar información en decisiones, desde la obtención y estructuración del dato hasta su análisis, modelización y comunicación a negocio.
A lo largo de su trayectoria ha desarrollado proyectos de analítica y Data Science aplicados a política, marketing, investigación de mercados y deporte, además de asesorar a organizaciones sobre sus datos, métricas y oportunidades de negocio. Como divulgadora, produce y presenta La Empresa Inteligente, un podcast sobre datos, inteligencia artificial y toma de decisiones empresariales, desde el que acerca estos conceptos a profesionales y organizaciones y explora cómo convertir la información en acción.
LinkedIn ↗Podcast: La Empresa Inteligente
En Conversaciones sobre datos hablamos con profesionales que trabajan en la intersección entre datos, tecnología y negocio para entender qué sabemos gracias a los datos, qué seguimos sin poder conocer y qué papel debe conservar el criterio humano.
Primera parteDatos, decisiones y lo que todavía no sabemos
01
¿Qué papel juegan hoy los datos en tu trabajo y en las decisiones que ayudas a tomar?
Los datos no solo juegan un papel fundamental en mi trabajo, sino también en mi forma de entender el mundo. Al final, vivimos rodeados de datos: señales que percibimos, consciente o inconscientemente, y que condicionan muchas de las decisiones que tomamos cada día.
En el ámbito profesional, esa relación se vuelve consciente y estructurada. Los datos tienen un papel completamente transversal en mi trabajo porque me permiten entender dónde estoy, dimensionar un problema, detectar patrones y anomalías y decidir hacia dónde merece la pena avanzar.
Para mí sería como intentar llegar a un sitio en el que nunca has estado sin GPS y sin señales en la carretera: puedes avanzar, e incluso acertar, pero no sabes realmente si vas en la dirección correcta. Los datos son esas señales. Están ahí; la diferencia está en saber identificarlos, interpretarlos y convertirlos en información útil para decidir.
Eso se aplica prácticamente a cualquier problema con el que trabajo: comportamiento de clientes, marketing, segmentación, pricing, rendimiento, detección de anomalías… Cambia la decisión, cambia el contexto y cambian los datos, pero su papel sigue siendo el mismo: reducir la incertidumbre y ayudarnos a comprender mejor la realidad sobre la que estamos decidiendo.
02
¿Qué sabemos hoy gracias a los datos y qué cosas importantes seguimos sin poder conocer?
Hoy los datos nos permiten conocer y comprender aspectos de la realidad a una escala que hace unas décadas habría sido difícil imaginar. Y no hablo únicamente de problemas de negocio. Los datos son tan transversales e inherentes a nuestra vida que prácticamente cualquier ámbito puede convertirse en una fuente de información.
Podemos estudiar desde cuestiones macro, como la volatilidad de un activo financiero, hasta comportamientos muy cotidianos: qué compra una persona, dónde hace clic o qué comparte. Pero también podemos observar cómo evoluciona nuestra salud, cómo dormimos, cómo nos movemos o cómo responde nuestro cuerpo a determinados estímulos. Generamos datos prácticamente desde que nos levantamos hasta que nos acostamos y seguimos generándolos mientras dormimos.
Por eso, ante la pregunta de qué sabemos hoy gracias a los datos, casi me resulta más interesante darle la vuelta: ¿qué seguimos sin poder saber?
Y creo que ahí aparece una paradoja. Tenemos una capacidad extraordinaria para medir la realidad, pero no siempre somos conscientes de lo que nuestros datos no nos están contando. Un indicador puede ser perfectamente correcto y, aun así, mostrarnos solamente una parte de la película.
Lo he visto en situaciones muy sencillas. Imaginemos que una organización participa en un evento para captar potenciales clientes de dos líneas de negocio. Al terminar, una de ellas ha generado numerosos leads y la otra prácticamente ninguno. Si observamos únicamente el resultado, podríamos concluir que existe mucho más interés por la primera. Pero después descubrimos que durante el evento los esfuerzos de prospección se concentraron casi exclusivamente en esa línea. El KPI era correcto; la conclusión que estábamos a punto de extraer de él, no.
Ese tipo de situaciones me parecen especialmente peligrosas porque no estamos ante un dato evidentemente erróneo. Estamos ante información fragmentada que puede producir una historia aparentemente coherente. Y cuanto más convincente parece esa historia, más fácil es tomar una decisión equivocada a partir de ella.
Además, incluso cuando disponemos de una buena observación del comportamiento, sigue existiendo otra frontera: el porqué. Podemos observar que alguien compra, abandona, hace clic o deja de utilizar un servicio, e incluso inferir intereses, hábitos o preferencias combinando distintas señales. Pero una conducta observable no nos proporciona necesariamente su causa.
Por eso creo que trabajar con datos exige también desarrollar una cierta conciencia sobre sus límites. No basta con preguntarnos qué sabemos; debemos preguntarnos qué información falta, cómo se generaron los datos que tenemos, qué sesgos puede haber introducido el proceso y hasta dónde podemos llevar legítimamente nuestras inferencias.
En definitiva, los datos nos permiten saber muchísimo, pero una de las habilidades más importantes en analítica consiste precisamente en reconocer qué parte de la realidad estamos viendo y cuál sigue fuera de nuestro campo de visión.
El KPI era correcto; la conclusión que estábamos a punto de extraer de él, no.— Carmen Fernández Sobrino
03
¿Qué tipo de decisión crees que podría mejorar más si tuviéramos acceso a información diferente o más completa de la que utilizamos actualmente?
Creo que muchas decisiones mejorarían si entendiéramos que disponer de información más completa no significa necesariamente disponer de más datos, sino de más contexto sobre los datos que ya tenemos.
Tendemos a pensar en los datos como números, variables o comportamientos observables, pero todo dato se genera dentro de un contexto. Saber qué ha ocurrido es importante; entender en qué circunstancias ha ocurrido, qué factores podían estar influyendo y cómo se ha generado esa información nos proporciona una visión mucho más completa de la realidad que estamos analizando.
Esto me parece especialmente relevante cuando los datos describen o afectan a personas. Y no me refiero únicamente a entender por qué alguien compra un producto, abandona un servicio o responde a un determinado estímulo. Lo humano es mucho más amplio: incluye nuestra salud, nuestro comportamiento, nuestro entorno, nuestras relaciones y las circunstancias en las que vivimos y tomamos decisiones.
Podemos disponer, por ejemplo, de información muy precisa sobre una dimensión concreta de una persona y, aun así, estar observando solamente una parte de su realidad. Dos individuos pueden presentar un mismo comportamiento observable o una situación aparentemente similar y encontrarse, sin embargo, en contextos completamente diferentes. El dato puede coincidir; la realidad que existe alrededor de él, no.
Por eso, para mí, esa “información diferente” que muchas veces necesitamos es precisamente el contexto. No porque vaya a eliminar la incertidumbre, sino porque amplía nuestro campo de visión y nos permite interpretar con mayor criterio qué nos está diciendo un dato, qué puede estar quedando fuera y hasta dónde podemos llevar nuestras conclusiones.
Necesitamos una visión más completa de la realidad que esos datos intentan representar. Y cuanto más compleja y humana sea esa realidad, más importante se vuelve comprender el contexto que la rodea.
En términos de decisión, creo que esto mejoraría especialmente nuestra capacidad para adaptar productos, servicios e intervenciones a las personas a las que realmente van dirigidos, pues menos tendremos que depender de inferencias construidas únicamente a partir de señales parciales.
Eso no significa eliminar la incertidumbre ni asumir que podemos conocer completamente a una persona. Significa reducir la probabilidad de diseñar o decidir sobre una interpretación equivocada de sus necesidades. En negocio, por ejemplo, podría traducirse en una personalización más relevante, una segmentación más precisa o una propuesta de valor mejor ajustada; en otros ámbitos, en intervenciones mejor adaptadas a la realidad de las personas.
Imaginemos que una empresa automatiza buena parte de su atención al cliente. Los resultados iniciales son excelentes: disminuye el tiempo medio de resolución, baja el coste por incidencia y aumenta el porcentaje de consultas solucionadas sin intervención humana. A corto plazo, incluso las tasas de abandono permanecen estables. La empresa interpreta que la estrategia funciona y decide ampliar todavía más la automatización.
Sin embargo, los indicadores no están capturando una parte del contexto: cómo está afectando esa experiencia a la relación del cliente con la compañía. Muchas incidencias constan como resueltas, pero algunos clientes terminan el proceso sintiendo que no han sido escuchados o que conseguir una solución ha requerido un esfuerzo desproporcionado.
El problema aparece meses después. Cuando llega el momento de renovar o surge una alternativa comparable, parte de esos clientes tiene menos razones para permanecer. La compañía comienza a observar una caída de la retención y un aumento del abandono, pero para entonces lleva meses escalando precisamente una de las decisiones que ha contribuido a deteriorar esa relación.
Los datos iniciales eran correctos. Lo que faltaba era el contexto necesario para comprender qué se estaba optimizando y a costa de qué. Por eso, una decisión puede parecer excelente mientras medimos sus efectos inmediatos y revelarse perjudicial cuando ampliamos el campo de visión. El contexto no solo nos ayuda a interpretar mejor lo que está ocurriendo hoy; también puede evitar que optimicemos el presente a costa de deteriorar el futuro.
04
¿Dónde crees que debería situarse el equilibrio entre extraer valor de los datos y mantener la privacidad, el control y la confianza de las personas?
Creo que es una pregunta en la que merece la pena detenerse, porque no existe creación de valor sostenible si para conseguirla sacrificamos el control y la confianza de las personas. Los datos tienen un enorme valor económico y existe un mercado construido alrededor de ellos. Las empresas necesitan datos para conocer mejor sus mercados, desarrollar productos y tomar mejores decisiones, y es perfectamente legítimo que busquen obtener un beneficio de ello.
Pero hay un límite fundamental: el usuario nunca debería sentir que él es el producto sobre el que se está tomando una decisión que no comprende o que no puede controlar.
Para mí, el principio debería ser que la persona conserve la capacidad de decidir sobre el uso de sus datos personales. Y eso implica no solamente obtener una autorización, sino conseguir que exista un nivel suficiente de información y transparencia para que esa decisión sea realmente consciente.
Aquí aparece una dificultad importante: ejercer ese control requiere cierto conocimiento técnico y un esfuerzo que el usuario no siempre puede o quiere realizar. Podemos ofrecer políticas de privacidad, configuraciones y mecanismos de consentimiento, pero si para comprenderlos hace falta prácticamente una formación especializada, tenemos un problema.
Por eso creo que tenemos que seguir avanzando tanto desde la empresa como desde el Derecho y la protección del consumidor. Retirar un consentimiento o ejercer un derecho debería ser sencillo, rápido y tener la menor fricción posible, igual que debería serlo comprender qué estamos aceptando.
Al final, creo que la relación más saludable es aquella en la que ambas partes pueden obtener y percibir un valor: la empresa obtiene información que le permite mejorar y generar negocio y el usuario recibe a cambio productos, servicios o experiencias que le aportan valor. Pero esa relación solamente funciona mientras exista confianza.
El reto no es elegir entre privacidad y valor económico. Es construir un mercado del dato en el que podamos generar valor sin olvidar que detrás de cada dato sigue habiendo una persona con derechos.— Carmen Fernández Sobrino
05
Si miramos cinco años hacia adelante, ¿qué crees que cambiará en la relación entre personas, empresas y datos?
Creo que en los próximos cinco años la relación entre personas, organizaciones y datos va a ser mucho más estrecha y, sobre todo, mucho más cotidiana. Hoy generamos y cedemos una enorme cantidad de información, muchas veces sin ser plenamente conscientes del valor que tiene. Creo que eso va a cambiar.
Y cuando hablamos de organizaciones no pienso únicamente en empresas privadas. Las Administraciones Públicas también manejan volúmenes enormes de información sobre las personas. La diferencia es que su finalidad, sus estructuras y sus capacidades de explotación del dato son distintas de las de una empresa privada, que normalmente puede moverse con mucha más agilidad en este ámbito.
Mi impresión es que avanzaremos hacia un escenario en el que las personas seremos mucho más conscientes de que nuestros datos tienen valor. Dejaremos de percibirlos únicamente como algo que generamos al comprar, utilizar un servicio, contestar una encuesta o publicar una opinión y empezaremos a entenderlos como un activo sobre el que podemos ejercer un mayor control.
Incluso creo que podemos llegar a ver nuevas formas de intercambio económico alrededor del dato personal. No sé si jurídicamente hablaremos de cesión, licencia, prestación o si terminaremos desarrollando figuras específicas, pero sí creo que veremos mecanismos mediante los cuales una persona pueda decidir de forma mucho más consciente qué información comparte, con quién, para qué y qué obtiene a cambio.
En ese sentido, me gusta pensar en los datos casi como una divisa: algo que tiene valor y con lo que realizamos intercambios. La gran diferencia respecto a la situación actual sería que el usuario sería mucho más consciente de que está participando en esa transacción.
Por eso espero que una relación más estrecha venga acompañada también de una relación más transparente. El futuro no debería consistir simplemente en que las organizaciones sepan cada vez más sobre nosotros, sino en que nosotros sepamos también mucho mejor qué saben, para qué lo utilizan y qué valor estamos recibiendo a cambio.
Segunda parteObservar, preguntar y el porqué del dato
06
Desde el behavioral analytics, ¿hasta qué punto observar lo que hacemos permite entender realmente por qué lo hacemos?
Creo que el primer error sería pensar que behavioral analytics consiste únicamente en observar al ser humano. La observación del comportamiento es una parte fundamental, pero para mí el análisis debería ser bastante más complejo: observar conductas, compararlas con patrones históricos y, siempre que sea posible, escuchar y preguntar también al usuario.
Observar nos permite saber muchísimo. Podemos conocer qué compra una persona, dónde hace clic, cuándo abandona un proceso o cuánto tiempo permanece en él. Y sabemos además que las decisiones humanas no responden exclusivamente a una lógica racional: intervienen emociones, sesgos, contexto, experiencias previas y multitud de factores que podemos intentar identificar a través del comportamiento.
Pero observar una conducta no significa conocer necesariamente su causa. Dos personas pueden realizar exactamente la misma acción por motivos completamente diferentes. Ahí es donde creo que la mera observación empieza a quedarse corta.
Para mí, behavioral analytics debería intentar acercarse también a ese porqué. Y eso implica complementar el dato observado con otras fuentes de información y, cuando sea posible, con una comunicación directa con el usuario. No se trata únicamente de saber qué ha hecho, sino de comprender qué intentaba conseguir, qué necesidad tenía, qué fricción encontró o qué motivó finalmente su decisión.
Esta forma de verlo tiene mucho que ver con algo que aprendí mientras desarrollaba un proyecto de detección y priorización de cáncer de mama. Durante Santander Explorer, uno de mis mentores me hizo una observación que se me quedó grabada: puedes construir un producto que consideres extraordinariamente útil y, aun así, equivocarte si no has comprobado primero qué problema necesita resolver el mercado.
La idea era sencilla: el producto debería ser la respuesta a un pain real. No se trata de construir primero una solución y después intentar convencer al mercado de que la necesita, sino de comprender suficientemente bien al usuario como para diseñar algo que responda a una necesidad que realmente existe.
Me gusta compararlo con diseñar un vehículo. Antes de decidir el motor, las ruedas o la potencia necesitamos saber para qué vehículo estamos diseñando: no necesita lo mismo un deportivo que un tractor. Con una experiencia de usuario ocurre algo parecido: antes de optimizarla necesitamos comprender para quién la estamos construyendo y qué pretende conseguir esa persona.
Y esto es especialmente importante porque creo que las empresas ya no compiten únicamente por ofrecer productos o servicios. Cada vez compiten más por ofrecer experiencias que el usuario quiera integrar en su vida. Si ese es nuestro objetivo, el usuario necesariamente tiene que estar en el centro del análisis.
El comportamiento nos dice qué ha ocurrido; entender al usuario exige seguir investigando por qué ha ocurrido.— Carmen Fernández Sobrino
07
¿Dónde ves la mayor diferencia entre los datos que una empresa puede observar directamente y la información que necesita preguntar a las personas?
Creo que una de las mayores diferencias está en cuánto está dispuesto el propio usuario a contarnos espontáneamente. Hay ámbitos en los que las personas generan muchísima información sin necesidad de que nadie se la solicite. El análisis político es un ejemplo muy claro.
Considero que hay tres factores que influyen mucho en la predisposición de una persona a explicar espontáneamente por qué ha tomado una decisión: la inversión económica, la inversión emocional y la libertad que percibe a la hora de elegir.
No todas las decisiones de consumo ofrecen el mismo grado de libertad. En la compra de una vivienda o de un coche podemos tener preferencias muy claras, pero nuestra elección está fuertemente condicionada por el presupuesto. En cambio, dentro de un determinado rango de precio podemos encontrar decenas de perfumes, prendas, gimnasios, plataformas o dispositivos entre los que el usuario siente que ha podido escoger con mucha mayor libertad.
Y esa libertad de elección adquiere todavía más importancia cuando existe una inversión emocional. La política es un ejemplo extremo: votar una opción u otra prácticamente no cambia el coste económico para el individuo en el mero hecho de votar, pero puede existir una enorme inversión emocional, identitaria o ideológica detrás de esa decisión. Por eso genera tanta necesidad de expresarla, justificarla y compartirla.
Algo parecido, aunque a otra escala, puede ocurrir con determinadas decisiones de consumo. Cuando sentimos que podíamos escoger, hemos escogido y esa elección dice algo sobre nosotros, aumenta nuestra predisposición a hablar de ella.
Por eso no creo que la diferencia entre observar y preguntar dependa únicamente del tipo de dato disponible. También depende de cómo experimenta la persona su propia decisión. Cuanto mayor sea la libertad percibida de elección y mayor sea la implicación emocional, más probable es que parte de la motivación aparezca espontáneamente en su comportamiento y en lo que comunica. Cuando esa libertad es menor o la decisión se vive de manera más funcional, probablemente tendremos que preguntar mucho más para comprender el porqué.
En investigación y data science, sin embargo, muchas veces necesitamos una capa de profundidad que no aparece espontáneamente. Podemos observar una acción, pero necesitamos preguntar para conocer su contexto.
Pensemos en algo tan sencillo como dos personas que toman ibuprofeno. El comportamiento observable es idéntico: ambas han tomado el mismo medicamento. Pero una puede hacerlo por una migraña y otra por una lesión muscular. Si nuestro problema de investigación consiste en estudiar lesiones, observar únicamente el consumo del medicamento no nos permite distinguirlas. Necesitamos preguntar: ¿has sufrido una lesión?, ¿qué tipo de lesión?, ¿qué tratamiento has seguido? La misma conducta puede contener significados completamente diferentes dependiendo del contexto.
Por eso creo que la frontera entre observar y preguntar depende mucho del problema que queremos resolver. Para mí, la pregunta no debería ser simplemente “¿podemos observar este dato?”, sino “¿lo que estamos observando contiene realmente la información que necesitamos para responder a nuestra pregunta?”
08
¿Intentamos a veces compensar con modelos cada vez más sofisticados preguntas que quizá sería más sencillo preguntar directamente a las personas?
Creo que sí, aunque con matices. Es bastante lógico que ocurra. En data science venimos de una formación muy técnica, matemática y programática, y aprendemos a trabajar con modelos, algoritmos y capacidad predictiva. Cuando esas son nuestras herramientas y nuestra expertise, tendemos a pensar que también son las herramientas que van a resolver el problema.
Y creo que ahí puede aparecer nuestro propio sesgo profesional. Si tenemos datos imperfectos, nuestra primera reacción muchas veces es preguntarnos: ¿qué puedo hacer técnicamente para compensar estas limitaciones? Podemos buscar un modelo mejor, introducir nuevas variables o aumentar la capacidad predictiva. Pero quizá la pregunta anterior debería ser otra: ¿qué información me falta y cuál es la mejor manera de conseguirla?
A veces la respuesta será efectivamente un modelo más sofisticado. Otras veces será incorporar una nueva fuente de datos. Y otras puede ser mucho más sencillo preguntar directamente a las personas.
En data science sabemos además que el dato perfecto no existe. Siempre habrá ruido, sesgos, información incompleta o limitaciones, incluso cuando trabajamos con datos sintéticos. Para mí, el peligro aparece cuando intentamos resolver exclusivamente mediante sofisticación técnica una carencia que en realidad está en la información de partida.
Me gusta pensar en ello como un dato que presenta determinados síntomas. Podemos desarrollar tratamientos cada vez más sofisticados para compensarlos, pero quizá antes deberíamos preguntarnos si podemos actuar sobre la causa. Un modelo puede ayudarnos a trabajar mejor con la incertidumbre; no necesariamente puede crear la información que nunca hemos observado.
Por eso creo que necesitamos una visión mucho más cercana a 360 grados: combinar capacidad técnica con conocimiento del negocio, comprensión del usuario y también una perspectiva jurídica sobre qué datos podemos obtener, cómo podemos utilizarlos y cuáles son los límites.
El error no está en construir modelos sofisticados. El error está en confundir sofisticación con comprensión.— Carmen Fernández Sobrino
09
¿Deberíamos considerar también como parte de la calidad de un dato conocer el contexto, la intención o el motivo que hay detrás?
Por supuesto que sí. Creo que el contexto debería formar parte de nuestra valoración de la calidad de un dato, porque podemos tener información técnicamente completa, consistente y precisa y, aun así, interpretarla mal si desconocemos las circunstancias en las que se generó o pretendemos utilizarla.
Hay una analogía de la química que me parece especialmente ilustrativa: la talidomida y la quiralidad. Una molécula puede presentar distintas configuraciones espaciales y esas diferencias pueden modificar su interacción con los sistemas biológicos. La talidomida es un caso especialmente conocido y complejo: sus enantiómeros presentan diferencias en su actividad biológica y, además, pueden interconvertirse en condiciones fisiológicas. Precisamente por eso me parece una buena analogía: no basta con saber qué elementos tenemos delante; importa también cómo están configurados, cómo interactúan y en qué contexto lo hacen.
Con los datos ocurre algo parecido. Imaginemos un dataset perfectamente completo, consistente y preciso que segmenta una población por edad, sexo o determinadas preferencias. Ahora imaginemos que esos datos fueron recogidos inmediatamente antes de la pandemia de COVID-19 y pretendemos utilizarlos para explicar comportamientos posteriores. El dataset no se ha convertido en un mal dataset, pero el contexto en el que se generó ha cambiado radicalmente respecto al contexto que queremos analizar.
Por eso creo que, además de preguntarnos si un dato está completo, actualizado o correctamente registrado, deberíamos preguntarnos de dónde procede, en qué circunstancias se generó, qué pretendía medir y para qué queremos utilizarlo.
Y añadiría todavía otra dimensión: la intención. Podemos tener un registro perfectamente preciso de que una persona realizó una determinada acción, pero, si queremos explicar por qué la realizó, ese dato puede ser insuficiente aunque técnicamente sea impecable.
Para mí, por tanto, un dato no es de calidad solamente porque esté bien construido; también tiene que ser adecuado para la pregunta que queremos responder. Completitud, consistencia, precisión y actualización son fundamentales, pero sin contexto podemos tener datos excelentes y construir con ellos una explicación equivocada.
CierreLa pregunta que cierra todas nuestras conversaciones
10
Si pudieras hacer una sola pregunta a todas las personas relevantes para un negocio y obtener una respuesta completamente fiable, ¿qué preguntarías?
¿Qué es lo que te motiva a hacer lo que haces?
Y cuando hablo de motivación no pienso únicamente en aquello que nos impulsa positivamente. Me interesa también su reverso: qué nos frena, qué nos genera rechazo, cuáles son nuestras frustraciones, nuestros dolores o las barreras que hacen que no actuemos.
Porque para comprender una conducta necesito conocer tanto el motor como el freno. Quiero saber qué hace que una persona avance hacia una decisión, pero también qué hace que se detenga, abandone o escoja una alternativa.
Desde el punto de vista de negocio, ambas cosas son fundamentales. Si entiendo qué mueve a una persona, puedo diseñar una experiencia que conecte con sus necesidades y objetivos. Si entiendo qué la frena, puedo identificar fricciones y decidir cuáles puedo eliminar.
Por eso, si pudiera obtener una respuesta completamente fiable, mi pregunta seguiría siendo: “¿Qué es lo que te motiva a hacer lo que haces?” Porque dentro de ese porqué quiero entender tanto lo que te mueve como lo que te frena.
Conversaciones sobre datos
Una serie de deitta para escuchar cómo profesionales de distintos ámbitos entienden el valor de los datos, sus límites y las preguntas que todavía necesitamos responder.
Las respuestas publicadas corresponden a Carmen Fernández Sobrino y se presentan respetando el contenido facilitado para esta conversación.
¿Listo para eliminar el riesgo legal de tus datos?
Consigue insights de datos voluntarios, trazables, reutilizables y legalmente robustos.